
posts
Copilot en la empresa: atribución de telemetría sin capturar contenido
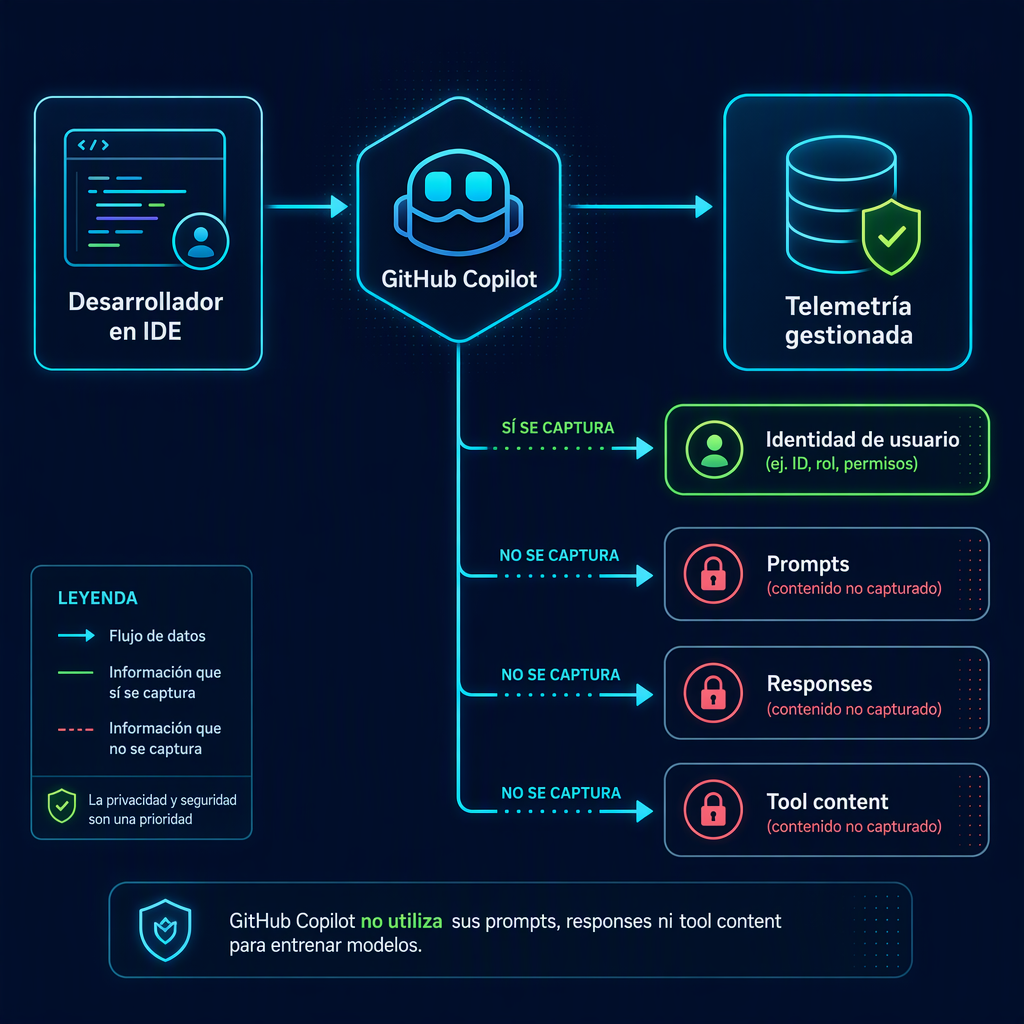
Cuando una organización adopta GitHub Copilot (GHC) en serio, el problema deja de ser «cómo lo activo» y pasa a ser «cómo lo gobierno». Y ahí es donde el anuncio de atribución de usuario y captura configurable en la telemetría cliente cobra mucha relevancia, pues ahora los administradores de empresa ya pueden atribuir a una persona la actividad de GitHub Copilot que los clientes gestionados exportan por OpenTelemetry sin recoger prompts, respuestas ni contenido de herramientas. Si tú estás en plataforma, seguridad o ingeniería interna, esto no es un detalle menor.
Hasta ahora, muchas discusiones sobre telemetría de asistentes de código se mezclaban con una preocupación completamente legítima: para saber quién hace qué, ¿había que aceptar también recoger contenido sensible? Y conviene precisar algo desde el principio, porque es fácil leer mal el anuncio: GitHub ya te decía, desde su propio portal, quién usaba GitHub Copilot y cuánto. Lo nuevo no es la atribución en sí, sino dónde ocurre y con qué nivel de detalle. Ahora puedes asociar a una persona (y a su máquina) cada traza de sesión que los clientes de GHC envían a tu colector, sin que eso arrastre el contenido de la interacción. GitHub introduce una captura configurable que separa la identidad del usuario de los datos de contenido. Es una feature para que tú construyas las piezas de política, cumplimiento y estandarización de tu organización para poner orden en el uso de IA dentro de los procesos de desarrollo.
A mí este tipo de cambios me interesan especialmente porque suelen pasar más desapercibidos que una nueva capacidad de generación o una demo vistosa. Pero, en la práctica, son los que permiten que una iniciativa salga del piloto simpático y entre en el terreno de la operación real. La IA empresarial madura cuando deja de ser solo útil y empieza a ser gobernable. Y el gobierno, para bien o para mal, es monitorizar “quién” hace “qué”, “cómo” lo hace y “cuándo”. Lo bueno de esta actualización es que nos separa el “qué” y el “quién” del “cómo”, con lo cual en ciertos entornos muy restringidos a temas de privacidad agrega mucha flexibilidad.
Lo que ya teníamos: las métricas de uso en el portal de GitHub
Antes de entrar en lo nuevo, merece la pena repasar qué te daba GitHub hasta ahora, porque sin ese contexto la novedad se sobrevalora o se infravalora, según quién la lea.
Desde la pestaña Insights de la empresa, en la sección Copilot usage, tienes desde hace tiempo un conjunto de paneles bastante completo. Según la documentación de métricas de uso de Copilot, hoy conviven cinco piezas:
- El dashboard de métricas de uso, que muestra tendencias de los últimos 28 días a nivel de empresa y de organización: usuarios activos diarios y semanales, tasa de aceptación, uso por funcionalidad, modelo y lenguaje.
- El dashboard de generación de código, que desglosa cuánto código generan las personas y cuánto los agentes.
- El dashboard de impacto, que agrupa a los usuarios en cohortes de adopción (pasivos, code first, agent first y multiagente), las relaciona con los pull requests fusionados e incluso ofrece una estimación de retorno de inversión.
- La API REST de métricas de uso, con informes de 1 y de 28 días a nivel de empresa, organización, repositorio y usuario.
- La exportación NDJSON, pensada para llevar los datos en bruto a tu herramienta de BI o a un almacenamiento de largo plazo.
A esto se suma la vista de licencias de cada organización (Settings → Copilot → Access), donde puedes ordenar a las personas por su última actividad y descargar el Activity report, y la API de gestión de usuarios de Copilot, que expone el famoso last_activity_at de cada asiento. Es decir: la atribución nominal ya existía. Si querías saber si X persona usa su licencia, el portal te lo decía. Pero para acceder hace falta tener habilitada la política Copilot usage metrics y ser propietario de la empresa u organización, billing manager, o tener un rol personalizado con el permiso de ver métricas de GHC, tal y como explica la guía del dashboard de métricas de uso. Y en ningún caso estas métricas contienen prompts ni respuestas: miden eventos, conteos, líneas de código y aceptaciones.
¿Qué no te daba ese portal? Básicamente cuatro cosas:
- Granularidad de sesión. Son agregados diarios o de 28 días. Te dicen cuántas interacciones de agente tuvo alguien, pero no la secuencia de una sesión concreta: qué modelo se llamó, qué herramienta se ejecutó después, qué servidor MCP intervino. Son meros contadores agregados y acumulados.
- Contexto del puesto. La identidad es el login de GitHub. No sabes desde qué máquina ni con qué cuenta del sistema operativo se trabajó.
- Control del dato. Los datos viven en GitHub, con la latencia, el acceso y las reglas que GitHub define.
- Independencia de la telemetría que viaja a GitHub. Y esto no es teórico. Hace apenas una semana, GitHub explicaba en este aviso sobre la actividad de agente en las métricas que varios IDE habían movido las sesiones de agente al Copilot SDK sin identificar de qué IDE venían; resultado: esa actividad quedó en gran parte fuera de los informes, otra parte se contó como Copilot CLI, y no se puede recuperar. Si tu gobierno dependía solo de ese panel, tenías un agujero sin saberlo.
Y había una pieza más que conviene conocer: los clientes de Copilot ya podían exportar telemetría OpenTelemetry a tu propio backend (trazas, métricas y eventos), pero la identidad que viajaba era un identificador tipo pseudónimo. Útil para ver patrones; insuficiente para saber de quién era una sesión concreta cuando realmente lo necesitabas. Ese es exactamente el hueco que rellena el anuncio.
Qué cambia exactamente
La pieza central es el ajuste telemetry.capture.identity, detallado en la referencia de enterprise managed settings. Cuando lo activas, la telemetría OpenTelemetry incorpora tres atributos:
user.name: la cuenta autenticada de Copilot (hoy, el login de GitHub).process.user.name: la cuenta del sistema operativo local.host.name: el nombre de la máquina.
Viene desactivado por defecto y es independiente del identificador pseudónimo que ya existía (enduser.pseudo.id), que se sigue enviando igual. Además, el contenido se divide en cinco clases de captura que puedes activar de forma independiente: prompts, responses, toolArguments, toolOutput y policyDetail. Todas apagadas por defecto.
Hay tres detalles que, para mí, son los que de verdad hacen que esto sea gobernable:
- Los valores gestionados mandan. Lo que fijes en la configuración gestionada tiene prioridad sobre los ajustes locales, la configuración del SDK y las variables de entorno. El desarrollador no puede «reactivar» la captura de prompts por su cuenta.
- El atajo antiguo no cuela identidad. El ajuste heredado
captureContentsigue existiendo como switch de las cinco clases de contenido, pero nunca activa la identidad. Separación real, no cosmética. - La cobertura no es homogénea. Los controles finos funcionan en Copilot CLI, en la app de GitHub Copilot y en las sesiones de VS Code que usan Agent Host. El arnés local de VS Code solo respeta
identityy elcaptureContentheredado. Si tu flota es mayoritariamente de VS Code, revisa esto antes de prometer nada.
Dicho de forma práctica, esto te permite responder preguntas que el portal no respondía: qué hizo esta sesión de agente, desde qué puesto, con qué herramientas y servidores MCP (por identificador, no por contenido), y bajo qué cuenta. Todo ello sin entrar en el terreno mucho más delicado de inspeccionar lo que una persona escribió o recibió. En mi experiencia, ese equilibrio es justo el que muchas empresas estaban esperando para pasar de pilotos aislados a una adopción más seria. Medir sin jusgar, pero con responsabilidad en caso de un uso inapropiado.
También me parece interesante leer esta novedad en el contexto de otros movimientos recientes de GitHub orientados a mejorar la atribución y reducir la ambigüedad operacional. Por ejemplo, en la vista previa de push attribution para commits, GitHub explica que ahora registra de forma duradera qué usuario autenticado hizo el push de cada commit, además de los campos clásicos de autor y committer. No es lo mismo que la telemetría de GHC, pero la dirección es parecida: distinguir mejor identidad, acción y contexto para que auditoría y trazabilidad no dependan de suposiciones ni de convenciones heredadas.
Portal frente a OpenTelemetry: dos planos que no compiten
Si tuviera que resumir la diferencia en una tabla, sería esta:
| Métricas del portal de GitHub | Telemetría OTel con capture.identity | |
|---|---|---|
| Dónde viven los datos | En GitHub (dashboards, API, NDJSON). GitHub gobierna el dato y su ciclo de vida (28 días máximo) | En tu colector OTLP y tu backend de observabilidad. Tu gobiernas el dato y su ciclo de vida |
| Granularidad | Agregados diarios y de 28 días por empresa, organización, repositorio y usuario | Trazas, métricas y eventos por sesión, paso a paso, el tiempo que la organización decida preservarlos |
| Identidad | Login de GitHub y last_activity_at | user.name, process.user.name y host.name (además del pseudónimo - login de GitHub) |
| Contenido | Nunca | Apagado por defecto; cinco clases activables por separado |
| Latencia | Hasta dos o tres días UTC | Lo que tarde tu pipeline |
| Superficies | IDE soportados, Copilot CLI y agentes; no incluye Copilot Chat en GitHub.com ni GitHub Mobile | Copilot CLI, app de GitHub Copilot y VS Code (cobertura parcial según el harness) |
| Quién decide acceso y retención | GitHub, más los roles que asignes | Tú (y, por tanto, también es tu responsabilidad) |
| Pregunta que responde | ¿Se está adoptando? ¿Compensa? ¿Quién no usa su licencia? | ¿Qué pasó exactamente, quién lo hizo y desde dónde? |
La lectura que hago es sencilla: el portal es para gestionar la adopción; OpenTelemetry con identidad es para auditar la operación y potenciar el gobierno. No son alternativas, son capas que se complementan. Y el error que veo venir es usar uno para lo que está pensado el otro: montar en tu Grafana una réplica casera del dashboard de adopción, o pretender investigar un incidente con agregados de 28 días.
Por qué esto le importa más a plataforma que a desarrollo
Si tú desarrollas producto, probablemente esta noticia no te cambie el día a día en el editor. No vas a abrir el IDE mañana y pensar «qué bien, ahora tengo atribución de telemetría». Sería rarísimo. De hecho, de saberlo hasta seguro que no te gustaría. Pero si te encargas de una plataforma de desarrollo interna y de gobierno, sí hay una diferencia clara, porque el valor no está en una nueva capacidad de generación, sino en una nueva capacidad de control.
Cuando estandarizas GHC a nivel corporativo, casi siempre necesitas responder cuatro preguntas incómodas:
- La primera es de adopción: quién lo usa realmente.
- La segunda es de coste: si las licencias y el uso se corresponden.
- La tercera es de cumplimiento: si la organización puede demostrar que aplica sus políticas sin invadir contenido sensible.
- La cuarta es de confianza: si el equipo de desarrollo percibe que la empresa está midiendo uso, no vigilando texto.
Las dos primeras, siendo justos, ya las respondía razonablemente bien el portal, con sus cohortes, su last_activity_at y su estimación de retorno. Con este anuncio, yo veo un avance claro en la tercera y la cuarta. No es lo mismo observar eventos de uso atribuibles que capturar interacción semántica. A nivel de privacidad, de comité de seguridad y hasta de comunicación interna, esa diferencia importa muchísimo. Muchas implantaciones de IA no tropiezan por falta de tecnología, sino por una definición pobre del perímetro de datos y por una narrativa interna francamente mejorable.
La tensión real: auditoría frente a privacidad
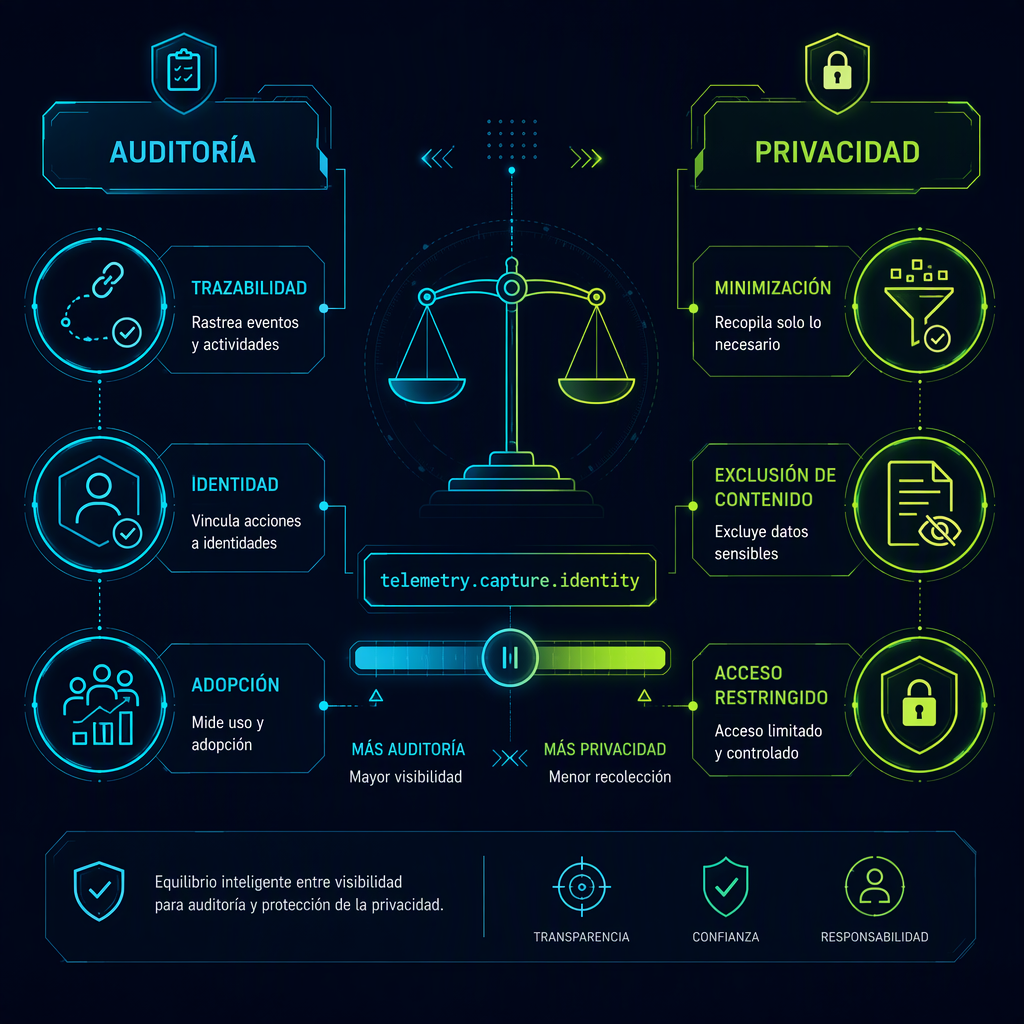
Aquí está el punto que más me interesa. En gobierno de plataformas siempre hay una tensión entre trazabilidad y minimización. Si recoges demasiado poco, no puedes auditar. Si recoges demasiado, erosionas privacidad, aumentas superficie de riesgo y complicas cumplimiento. Lo valioso de esta funcionalidad es que intenta mover esa frontera sin obligarte a elegir entre ceguera operativa e inspección excesiva. Eso no elimina todos los debates, por supuesto. Seguirá habiendo preguntas sobre retención, acceso, agregación por equipos, exportación o integración con herramientas corporativas. Pero sí cambia el punto de partida, porque ya no tienes que plantear el control como un todo o nada.
Ahora bien, hay un matiz que no quiero que se pierda: «sin contenido» no significa «anónimo». El login de GitHub, la cuenta del sistema operativo y el nombre de la máquina son datos personales a todos los efectos, y combinados con trazas de sesión dibujan un patrón de actividad bastante preciso. Si trabajas en España o en la UE, esto entra de lleno en el RGPD (o GDPR si te gusta como a mi decirlo en inglés) y, en el ámbito laboral, en las garantías de la LOPDGDD sobre el uso de dispositivos digitales, que suelen implicar informar a la plantilla (y, según el caso, a su representación legal) de qué se registra y con qué criterios. No soy abogado, así que no te voy a decir qué te obliga exactamente; lo que sí te digo es que esa conversación con legal tiene que ocurrir antes de activar el ajuste, no después.
Qué haría yo como administrador o equipo de plataforma
Yo no me lanzaría a activar nada sin un marco de decisión claro. Aunque la configuración telemetry.capture.identity es trivial de escribir, la parte difícil no es técnica, sino organizativa. Y, sinceramente, ahí es donde suelen torcerse estas cosas. Las reglas del juego deben estar claras, ser sencillas y fáciles de consultar.
Primero, definiría el objetivo exacto de la atribución. No es lo mismo querer medir adopción por unidad de negocio que necesitar trazabilidad nominativa para incidentes o uso indebido. Para lo primero, probablemente te baste con el portal y no necesites activar nada nuevo. Si no distingues esos casos desde el principio, acabarás pidiendo más dato del necesario por simple inercia defensiva. Y eso, además de innecesario, suele salir caro en confianza.
Segundo, documentaría de forma explícita qué no se captura. Aquí el propio anuncio ayuda mucho, porque no recoger prompts, respuestas ni contenido de herramientas es una frase muy potente para una política interna, siempre que la uses con precisión y sin prometer más de lo que la documentación cubre. Por ejemplo, no prometas que nunca se registran rutas: eso depende de que policyDetail siga apagado. Parece obvio, pero no siempre se hace bien: una política imprecisa genera más ruido que tranquilidad.
Tercero, separaría gobierno de vigilancia. En una implantación sana, la telemetría se usa para adopción, soporte, capacidad y cumplimiento; no para evaluar productividad individual con métricas simplistas. Esto no va de 1984 y ser el Gran Hermano del uso de GHC. Sé que la tentación existe (y bastante, sobre todo ahora que el dashboard de impacto te pone delante cohortes y multiplicadores de pull requests), pero me parece un error de manual. Convertir los eventos de uso de GHC en una especie de KPI personal casi siempre produce incentivos malos, comportamientos artificiales y conclusiones bastante pobres.
Cuarto, revisaría cómo encaja esta señal con las que ya tienes. Por un lado, las métricas del portal: el login de GitHub es la clave natural para cruzarlas con tus trazas, pero espera discrepancias, porque las fuentes, las superficies de consumo o uso y las latencias no son las mismas. Por otro, la novedad de push attribution para commits, que refuerza la idea de que la auditoría en GitHub se está volviendo más precisa en distintos planos: quién genera interacción asistida, quién empuja cambios y bajo qué identidad autenticada ocurren ciertas acciones. Juntas, estas capacidades pueden darte una imagen operativa más limpia, siempre que no mezcles conceptos que no son equivalentes. Porque sí, también se puede caer en el error contrario: ver tres fuentes de atribución y pensar que cuentan la misma historia. Te advierto: no la cuentan.
Un ejemplo de política mínima y sensata
Aquí, a diferencia de lo que suele pasar con este tipo de anuncios, sí hay sintaxis oficial publicada. La configuración vive en el objeto telemetry de los managed settings de la empresa, y una versión mínima orientada a atribuir sin capturar contenido se parecería a esto (el endpoint y los atributos de recurso son, evidentemente, los tuyos):
{
  "telemetry": {
    "enabled": true,
    "endpoint": "https://otel-collector.contoso.com",
    "protocol": "http/protobuf",
    "capture": {
      "identity": true,
      "prompts": false,
      "responses": false,
      "toolArguments": false,
      "toolOutput": false,
      "policyDetail": false
    },
    "lockCaptureContent": true,
    "serviceName": "copilot",
    "resourceAttributes": {
      "deployment.environment": "production"
    }
  }
}
Fíjate en dos cosas. Dejo las cinco clases de contenido en false de forma explícita, aunque sea el valor por defecto, porque un fichero de configuración también es documentación. Y activo lockCaptureContent para que ningún ajuste local pueda reactivar el contenido por la puerta de atrás. Si tu colector necesita autenticación, el objeto admite cabeceras; en ese caso, HTTPS sí o sí.
Pero el JSON es la parte fácil. Lo que de verdad merece la pena es el artefacto de gobierno interno que lo acompaña, para que la decisión no se quede en una conversación de pasillo:
copilotTelemetryPolicy:
  scope: enterprise-managed
  sources:
    githubUsageMetrics: adopcion_y_licencias   # Dashboards e informes del portal
    otelCollector: auditoria_operativa          # Trazas en nuestro backend
  capture:
    identity: true        # Atribuyo uso por persona y puesto sin abrir la puerta al contenido
    prompts: false
    responses: false
    toolArguments: false
    toolOutput: false
    policyDetail: false
  allowedPurposes:
    - adopcion
    - auditoria_operativa
    - soporte
  forbiddenUses:
    - evaluacion_individual_de_productividad
    - inspeccion_de_contenido_sin_base_formal
  accessControl:
    principle: least-privilege
    reviewCadence: quarterly
  retention:
    otelTraces: definir_con_legal
Lo importante no es el YAML en sí (de nuevo, los nombres no son mi fuerte 😅), sino la disciplina que representa. Si tú eres responsable de plataforma, te conviene traducir anuncios como este a decisiones verificables: qué activas, con qué fin, quién accede, cuánto tiempo retienes, qué fuente usas para cada pregunta y qué usos quedan expresamente prohibidos. Si eso no queda escrito, en realidad no tienes una política; tienes una intención.
Qué conversación abriría yo ahora mismo
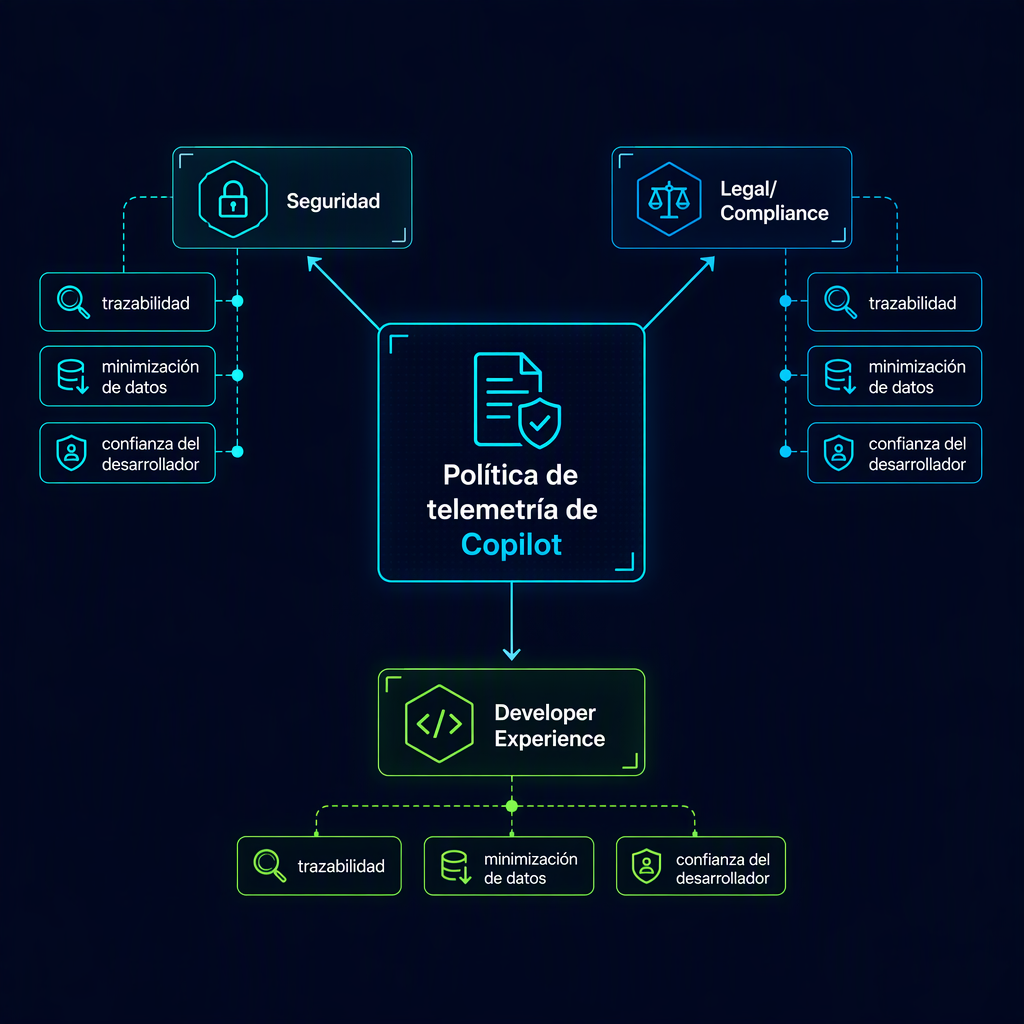
Yo abriría una conversación transversal con tres actores: seguridad, legal (compliance) y developer experience.
- Seguridad va a querer trazabilidad.
- Legal va a querer minimización y claridad sobre datos personales. Y seamos sinceros: que no haya una demanda.
- Developer experience va a querer garantizar que GHC sigue siendo útil, no hay impacto en el trabajo y que la confianza del desarrollador no se rompe.
Mi recomendación sería muy concreta: presenta esta novedad no como «ahora podemos saber quién hizo qué con Copilot», sino como «ahora podemos mejorar la adopción sin acusar». Parece un matiz de comunicación, pero no lo es en absoluto. Define el marco mental con el que la organización va a aceptar o rechazar la medida. Y, de paso, sé honesto con algo: el «quién» a nivel de licencia ya lo veíamos en el portal. Lo que cambia es el detalle operativo y que el dato pasa a estar bajo tu custodia y responsabilidad.
También aprovecharía para revisar inventario y consistencia. Muchas empresas tienen GitHub Copilot habilitado de forma desigual entre equipos, con políticas distintas según filial, país o unidad técnica. Una capacidad de telemetría mejor orientada puede servir para consolidar criterios y reducir excepciones, que casi siempre es donde nacen los problemas más incómodos. No porque las excepciones sean siempre malas, sino porque rara vez están bien explicadas, bien medidas y bien revisadas. Y ya que estás, comprueba las versiones de los IDE: si tu flota no está al día, tanto el portal como tus trazas te contarán una historia incompleta.
Mi conclusión
Este anuncio de GitHub no va de construir nada nuevo en tu pipeline, ni de añadir una gran capacidad visible para quien programa. Tampoco sustituye a las métricas que ya tenías en el portal de GitHub, que siguen siendo la mejor herramienta para entender la adopción. Va de algo menos vistoso y, para la empresa, probablemente más importante: hacer gobernable el uso de GitHub Copilot en la propia telemetría de la organización, con un mejor equilibrio entre auditoría y privacidad, siendo dueños de la data y su ciclo de vida.
Por eso me parece relevante, pues cuando una plataforma de desarrollo incorpora IA, el reto real no suele ser encender la funcionalidad, sino decidir qué observas, para qué, y hasta dónde llegas sin invadir más de la cuenta. Si esta novedad se implementa con criterio, puede ayudar a profesionalizar el despliegue de GHC en organizaciones grandes sin convertir la telemetría en una caja negra incómoda.
Y si tú estás justo en ese punto de madurez, yo me quedaría con una idea muy simple: atribuir uso no debería obligarte a capturar contenido. Cuando esa separación existe, y además se comunica bien, la adopción empresarial tiene muchas más opciones de salir bien.
Comentarios